为什么Agent必然会走向Swarm形态?
作者:wangleineo
发布于 2026-10-13 11:29・日本
来源:知乎专栏
今天读到一篇 PrimeIntellect 工程师的文章,很有启发性。
https://www.primeintellect.ai/blog/on-the-nature-of-the-swarm
文章论述了为什么 Agent 一定会走向蜂群(Swarm)的形态,梳理了 Agent 发展的历史脉络。一个只有 2-3 年的技术,也能谈历史发展,可见技术演进的速度之快。
自从我们发现 Test-time Scaling 的强大,开始研发推理模型,就一直在时间的维度上扩展AI计算。但是,模型的思考长度受到 Context Window 的限制,所以出现了第一个 Agent 创新:Compaction。但是,Compaction 是有损的,被压缩掉的信息可能仍然有价值,所以我们又用持久存储 + Context 内指针的形式来压缩 Context,有用的信息在需要时,仍然可以读回来。但这个方案仍然有弊端,经常需要反复读取内容。我们发现 SubAgent 是一种管理 Context 的好方法,对于只需要结果,不需要了解过程的计算,可以委托给 SubAgent 去处理,大大节省了 Context 空间。但是,SubAgent是易失的,如果我们再次需要同样的计算,还要再次启用同样的 SubAgent。所以,出现了现在的“持久化 SubAgent”的技术路线:SubAgent结束以后,还可以“原地待命”,继续回答任务相关的问题。这种持久化的 SubAgent,可以理解为一个拥有智能的“指针”。
接下来,就是 Agent 组织方式的演进。一开始,我们采用 Coordinator + Worker 的形态,由此演化出 Agent 树状的组织架构:主 Agent 委派任务,子 Agent 负责执行并上报。但是,很快就发现,主 Agent 成了信息流动的中心和瓶颈,SubAgent 之间可以直接交流的信息,一定要走先上报再委派的冗余路径,降低了效率,浪费了很多 Context 空间。所以出现了更加扁平的组织结构,也就是蜂群(Swarm)的形态,Agent之间可以直接通信。但是,作者也提到,这个蜂群也需要中心节点,否则会导致决策效率的低下。就和自由市场经济中,仍然需要公司这种中心化的组织一样,Agent 的组织形态也有类似的规律。其实,我们不过是再次发现了管理学理论而已。
下面是博客原文的翻译:
论蜂群的性质
让我们从一个所有人都应该能同意的事情开始:推理扩展是有效的。事实上,它的效果如此之好,以至于 LLM 现在能够完成一些令人印象深刻的壮举,比如可信地声称解决了一个千禧年大奖难题。在我们发现推理遵循扩展定律之前,这看起来会显得荒谬。在测试时(test-time)给模型更多算力(让它思考更久、调用更多工具、检查自己的工作),它就会在任务上表现更好。只有一个问题:最终,你会耗尽上下文。
我是字面意思:你会填满预定义的上下文窗口。1上下文窗口也没有变得大很多:当前的前沿模型都封顶在约 100 万 token 左右。例如,你看不到任何严肃的模型拥有 1 亿 token 的上下文窗口。然而如今智能体经常执行那些仅凭 100 万 token 上下文本应不可能解决的任务。这怎么可能?
如果你在过去一年里用过 Coding Agent,你已经知道解释这种差异的魔术……压缩!
压缩
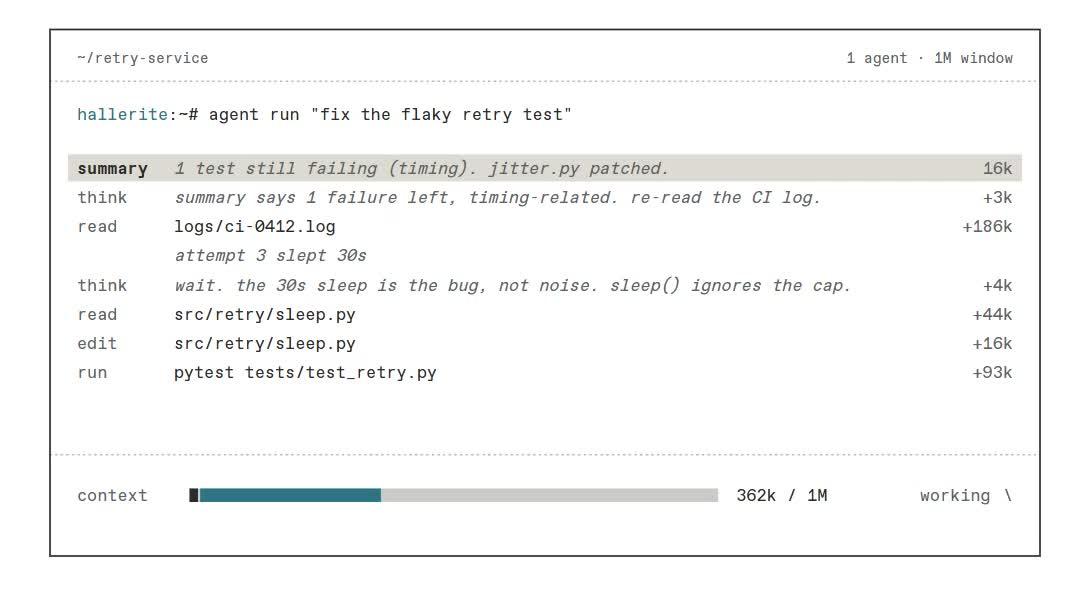
压缩是这样运作的:一旦接近上下文窗口的末端,你就让智能体写一份摘要,并把它的工作交接给一个全新的上下文;在那里这项工作被继续推进,直到上下文窗口再次被填满,你又得再次压缩。你一直这样做,直到(智能体认为)任务被解决。
压缩很神奇。它让你能让同一个智能体会话持续数天(或数周)而不会耗尽上下文。问题解决了,无限上下文,无限推理扩展,一切皆有可能。那我为什么还要写这篇博文?
嗯……压缩实际上并不给你无限上下文。它做的是另一件事。一件更微妙的事。它提升了我称之为模型的“总上下文容量”2的东西;粗略地定义,就是模型能承担的最大任务,而任务的大小是你要一次性完成它所需的窗口大小。压缩能在多大程度上超越模型预定义的上下文窗口,取决于智能体已经做过的事情中有多少必须在每次交接后存活下来。
这种限制背后的基本原则是:每一次压缩都是一次下注。进行摘要的智能体必须在现在决定什么在以后会重要。通常它猜得足够好,3但有些任务比其他任务更不容忍错误。4 大多数真实任务也是部分可观测的,所以某个你看到的东西是否重要,常常取决于你还没看到的东西。正如那句老话所说:“做出预测很难,尤其是关于未来的预测。”
让摘要损失更小的一种方式(或者用我们的术语说,提升总上下文容量)是让智能体使用文件系统或 REPL 来卸载记忆。例如,智能体可以把某个复杂工作流的细节写到磁盘上,并在摘要中放一个指向相关文件的指针。
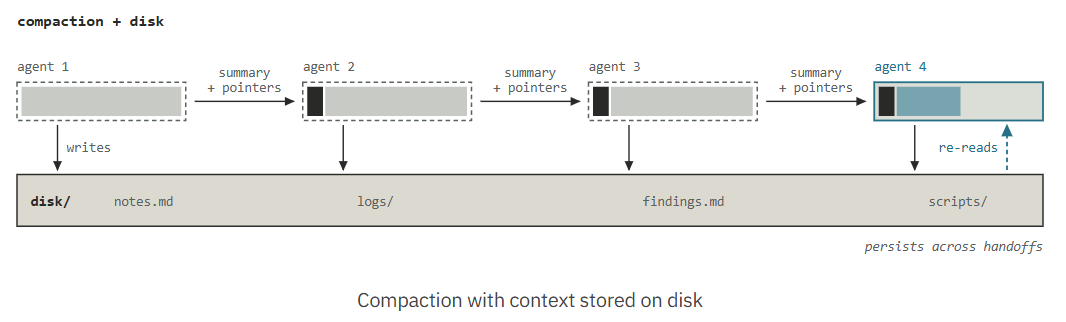
这实际上帮助很大!没有任何东西会因压缩的摧残而丢失。摘要只需要说明东西在哪里。所以我们的下注变得没那么可怕了:问题过去是“我需要记住什么?”,现在则是“我需要知道什么东西存在?”这很让人想起那句名言:“绅士不必懂拉丁语,但他至少应该已经把它忘掉。”5
但这仍然是一次下注,并且带来了一种新的成本。磁盘上的文件什么也不做;它们只是待在那里。6 要让其中任何东西有所帮助,下一个智能体必须 (a) 意识到它相关,(b) 去找到它,并且 (c) 把它读回自己的上下文。最后一步相当烦人,因为读取要消耗上下文,而上下文正是我们一开始就快用完的东西。7
换句话说,卸载到磁盘让我们能持久保存信息,但前一个上下文窗口中的智能体通过阅读全部内容所理解到的东西已经没了,而且每次有人需要时都必须重建。
那么我们完蛋了吗?也许吧。但我们还有几个锦囊妙计。
多智能体系统
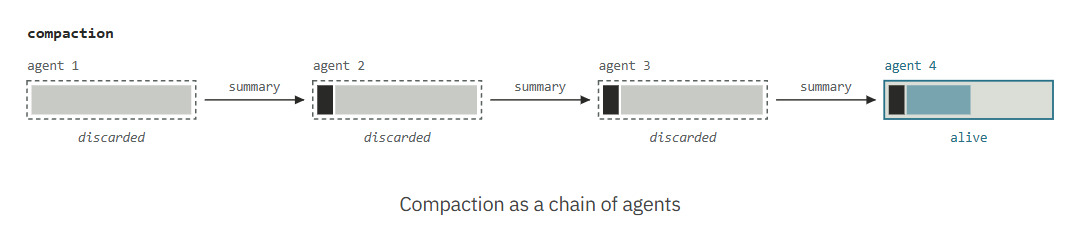
首先,注意我们可以把压缩框定为一个(退化的)多智能体系统:8每一次压缩都会启动一个新的智能体,其初始上下文是上一个智能体的摘要。第二种多智能体系统是一个主智能体协调子智能体。想法很简单:主智能体启动一个全新的智能体并给它一个任务(“找到重试逻辑在哪里”“弄清楚这个测试为什么不稳定”),然后拿回一个答案。子智能体可能会烧掉 20 万 token 来读文件、运行东西。主智能体的上下文只增长任务和答案那么多,也许几千 token。
现在有趣的部分来了。在我们的框定中,子智能体的答案就是……其上下文的摘要。所以子智能体实际上也是一种做压缩的方式!但有一个关键区别:摘要是在问题已知之后才写的。压缩必须猜测以后什么会重要。卸载到子智能体不需要猜测,因为你是在需要时才启动一个子智能体。9
额外好处是,如果你有几个独立问题,你可以同时派出几个子智能体。并行性是个不错的额外收获,但即使它们必须一个接一个运行,子智能体在这些任务上仍然会胜过压缩,原因如上。(这一点后面会很重要。)
子智能体特别适合那些适合分解为子任务、并且在交接和交付处有清晰边界的工作负载。对于这类任务,它们提升总上下文容量的程度远超压缩,因为主智能体永远不必持有混乱的中间部分。
但子智能体也并非没有缺点。它们有和磁盘相反的问题:它们会忘掉一切。一旦子智能体给出答案,它就没了,连同它那 20 万 token 的读代码、跑测试、排除各种可能性的经历一起消失。下次你有相关问题时,你又启动一个新的,它又把那些阅读全部重做一遍。你也不能在十轮对话之后追问它,比如“等等,你刚才那是什么意思?”
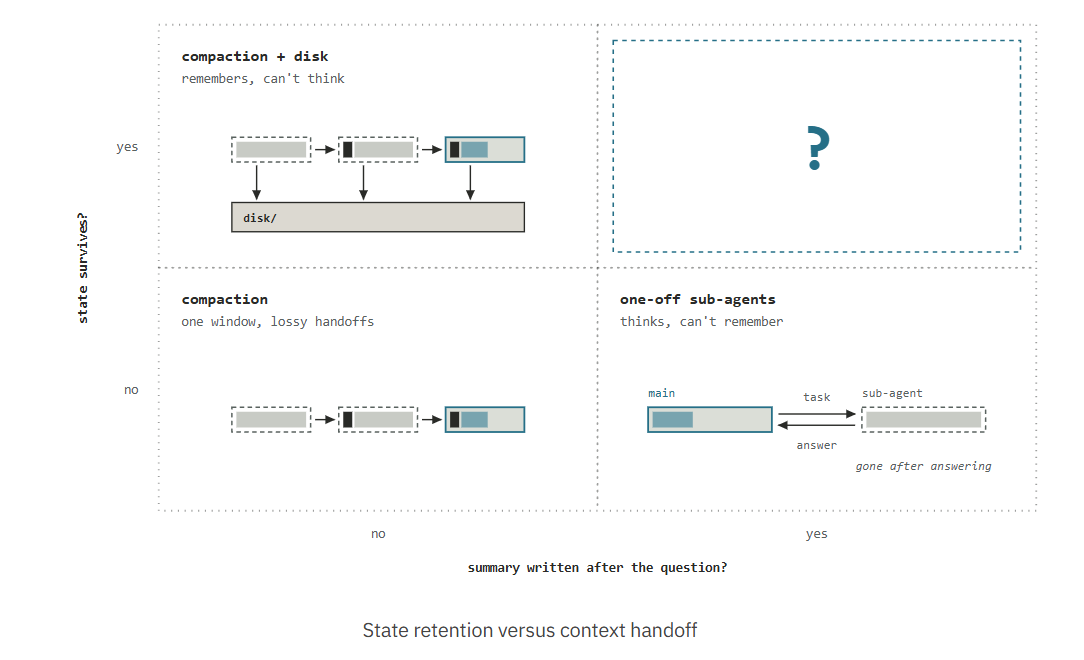
所以现在我们有两个半吊子解决方案。卸载到磁盘能记住,但不能思考。子智能体能思考,但不能记住。嗯。
雇用子智能体
你大概能看出这要往哪儿去了。第四个角落显而易见:就……别杀掉子智能体。把它留在身边。如果需要,就雇用它。就是别把它拆掉。
一个持久化的子智能体会保留其上下文(以及它的文件,还有它留下的任何仍在运行的东西)。当你对它参与过的某件事有新的问题时,你直接问它就好。它已经读过所有东西,所以不必从头开始,而你自己的上下文只增长问题和答案那么多。
现在我们兼得两者之长。和磁盘一样,没有什么会丢失。和子智能体一样,摘要在你知道自己需要什么之后才写。与两者都不同的是,你明天还可以带着不同的问题再问一次。这意味着压缩不再是一次性下注。你永远不必预先决定要保留什么,因为你总是可以回来再问。
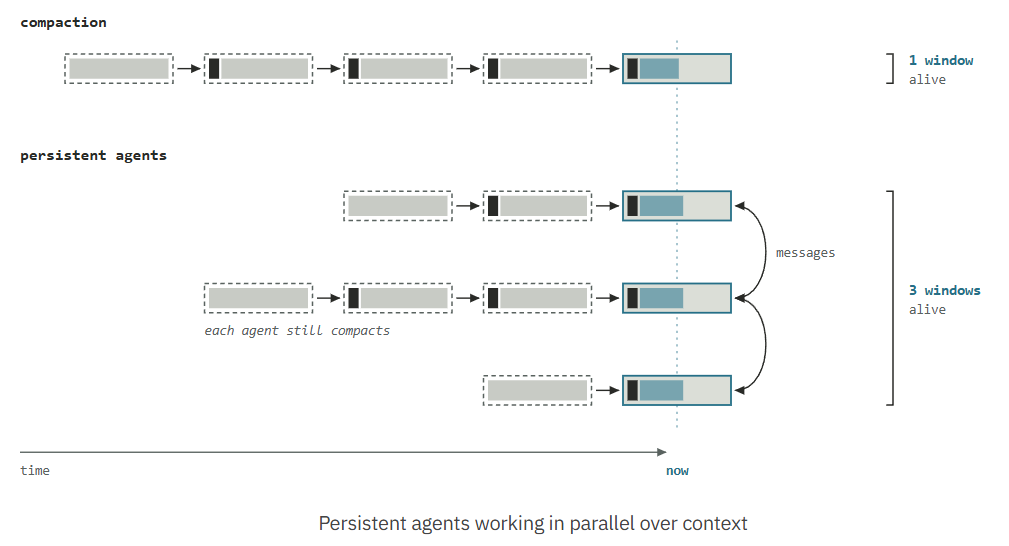
现在回到我们那个退化的多智能体系统。压缩是一串串联工作的智能体,每一个都依赖于前一个,而且在任何时刻只有一个是“活的”。任何没能进入摘要的东西都消失了,因为知道它的那个智能体已经消失了。
有了持久化智能体,若干个可以同时活着。当然,它们也可以同时运行:把问题拆成子问题,并行解决,更快完成。10这是支持多智能体的显而易见论点,11而且它是真的。从基础设施视角看,可以提出很好的论据来说明这为什么重要。但即使它们必须一个接一个轮流来,它们的上下文仍然会并排存在。它们在上下文上也是并行的,而这就是如今讨论不足的地方:总上下文容量会增长到(大约)每个智能体一个窗口。12
当然,这些智能体中的每一个仍然可以压缩!一个已经干了一阵子的子智能体可以像以前一样做摘要并继续前进。所以两者可以很好地叠加:压缩让每个智能体沿时间方向伸展,而更多智能体让整个系统向侧面伸展。你最终得到几条并排的链,它们可以互相询问。
没有免费午餐
让我们先拉远一点看。所有这些技巧实际上在做什么?压缩、卸载到磁盘、子智能体、持久化智能体:它们全都是构建上下文的方式。在理想世界里,你已经在一个窗口里拥有恰好正确的上下文,然后让模型吐出答案(或采取正确的行动序列)就行了。13 在实践中,模型必须把它构建出来。推理通过思考来构建它,智能体通过行动(读文件、跑测试)来构建它,而上面所有内容都是关于构建出比一个窗口能容纳的更多上下文。
一旦智能体在世界中行动,推理扩展在很大程度上看起来就是构建上下文。这也是为什么我强烈不同意许多人把多智能体称为“新的扩展轴”。我们仍然在扩展推理算力,只是以一种更有结构的方式来做。
当然,没有免费午餐。代价是通信。每当一段上下文需要从一个智能体传到另一个智能体,它都必须被挤进一条消息里,而这会消耗 token,并且本身是有损的。14 如果任务中困难的部分需要所有东西同时在一个地方,那么把它拆开根本不会有帮助。
说清楚一点,这一切都没有让我变得不那么乐观。OpenAI 刚刚让 10,000 个智能体解决了NS方程(纳维-斯托克斯)。15两年前,你很难找到一个神志正常的人会认为这会发生。但蜂群不是银弹。你不能只是把一百万个智能体扔向一个难题,然后指望答案掉出来。智能体首先必须足够好——好到能够有效地自我组织、互相协调,而不只是重复劳动。诚然,很多开销大概可以通过训练消除(让智能体擅长与成千上万个自己的副本一起工作),但有些通信成本是结构性的。
从树到蜂群
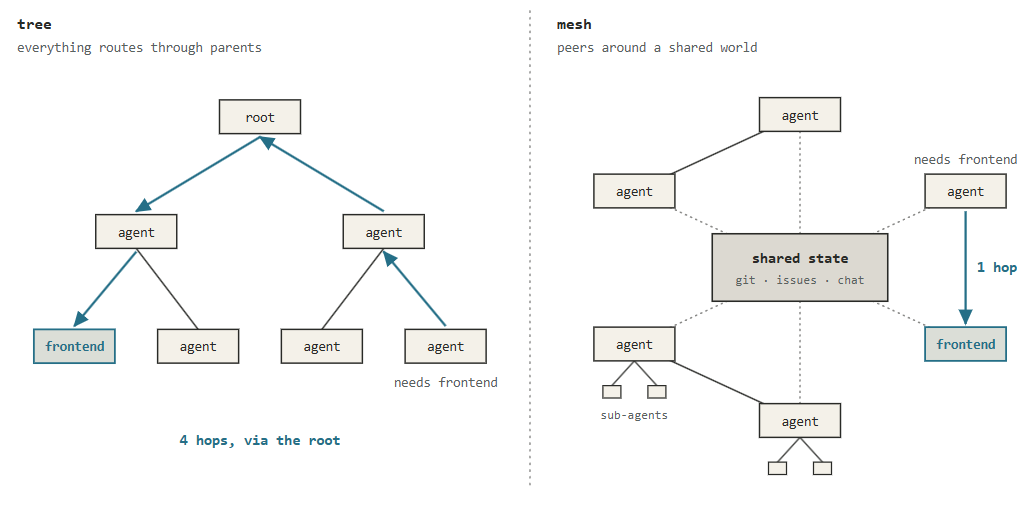
到目前为止,一切都是树:一个根智能体生成子智能体,子智能体又生成自己的子智能体,结果向上流回。但一旦智能体可以互相发消息,树就会把每一次对话都经由根路由。根的上下文会被填满,所以它必须压缩,然后……我们又回到了起点,只是上升了一层。树把上下文问题移到了根。
显而易见的修复办法是让兄弟节点直接互相交谈。但一旦兄弟节点可以和任何需要的人交谈,你就得问:根到底是干什么用的?没有人需要仅仅为了完成工作就受制于自己上面的人。干脆让它们全都变成对等节点。
所以:没有根。你把几个智能体放进一个共享世界,让它们作为网状结构中的对等节点彼此协调。就像每个智能体仍然可以压缩一样,每个智能体也仍然可以生成自己的子智能体。所以你可以在网状结构中拥有树。
这没问题。不过,去掉根并不意味着层级结构就没用了——毕竟公司仍然有 CEO。科斯在近 90 年前就问过这个问题:如果市场如此擅长协调,为什么公司还会存在?16他的回答是:因为使用市场不是免费的。每一次,你都必须找到对的人,解释你想要什么,并就条件达成一致。在公司内部,某个人可以直接决定。所以公司恰恰存在于这样做比作为对等方协调更便宜的地方。智能体也一样:从没有层级开始,然后在任何能回本的地方加一点层级。
这能起作用的原因之一是专业化。在蜂群中,没有人必须分配角色;角色会自己出现。假设某个智能体碰巧先看了前端。现在它在那里有了上下文,也许还做了一小件工具。所以下一个前端问题会去找它,因为这比其他人从零开始更便宜,而它回答的每一个问题都会让它在前端工作上更好一点。一个早期随机的差异会随着时间固化成一种角色。
树真正有害的地方在这里。向下两级的子智能体受制于其父节点:它只为生成它的那个智能体工作。所以如果我们的前端专家住在某个分支里,而另一个分支中的智能体有一个前端问题,它不能直接问。问题必须一路上行到它们的共同祖先,再一路下行,穿过那些根本不关心前端的上下文。
所以树有两个选择,都很糟。要么每个分支都长出自己的前端专家,于是我们又回到一遍又一遍重新发现同样东西的局面(而这正是持久化本该修复的)。要么其他分支没有它也行,而这位专家学到的一切只会帮助一个分支。在网状结构中,任何人都可以直接问它。它的上下文会被任何需要它的人复用。
智能体越多,这个问题就越严重。有 10 个智能体时,树大概还行。有 10,000 个时,让对等节点自己找到彼此并自行分工就合理得多。17
经济学家大约 80 年前就进行过这场争论。哈耶克的观点18是,中央规划之所以失败,是因为运行经济所需的知识分散在数百万人之中,无法全部送到中心。根智能体就是中央计划者。要规划得好,它需要整个上下文,而整个上下文恰恰是一个窗口装不下的东西。(这个类比要成立,蜂群并不需要价格或市场。重点只是知识住在哪里,以及谁有权据此行动。)
蜂群应该长什么样?
现在,我还不知道正确的结构是什么。纯粹的网状结构大概也不是。我的猜测是,我们从复制人类如何组织开始。给智能体我们使用的工具(共享 git 仓库、问题跟踪器、Slack),并让它们对共享状态拥有结构化访问权,而共享状态可以作为单一事实来源。正确的结构大概也取决于规模:一个五个人的初创公司可以靠几个 Slack 频道运转,而一个 10,000 人的公司则不能。布鲁克斯定律之类仍然好用。19
但事情是这样的:我们甚至不必锁定结构。我们可以让智能体自己改变它,而这就是我们让“苦涩的教训”重新发挥作用的方式。20所以我们可以用人类结构给蜂群播种,然后让智能体在解决手头问题的过程中改进它。
关于如何构建一个智能体蜂群,还可以说很多,但我会留到下次。
https://www.primeintellect.ai/blog/on-the-nature-of-the-swarm#compaction
参考
Footnotes
-
不要与“上下文腐烂”混淆:那是指智能体随着上下文被填满而变差的现象,因此“有效”上下文窗口(智能体表现处于峰值的窗口)小于其标称窗口 ↩
-
这是我编的。如果你有更好的名字,或者已经用不同名字发明了这个概念,告诉我。 ↩ ↩
-
根据我的经验,对于大多数任务,一个 100 万 token 的工作上下文可以相当漂亮地压缩成 16k token。 ↩
-
想想一次漫长的调试会话:第一天,一次不稳定的测试运行打印出一行奇怪的内容,你把它当作噪声忽略掉,于是摘要把它丢掉了。这个不稳定的问题再也没有出现。到了第三天,那一行本该是解开整个 bug 的关键,但没有人记得它存在过。注意,更聪明的摘要器在这里也救不了你:在第一天,根据当时任何人所知,丢掉那一行是合理的判断。 ↩
-
通常被归于 Brander Matthews。塞缪尔·约翰逊在 1775 年更字面地表达了同样的观点,据 James Boswell 记载:“知识有两种。要么我们自己知道一个主题,要么我们知道可以在哪里找到关于它的信息。” ↩
-
而当它们待在那里时,世界仍在前进:文件会被覆盖,状态会变化,所以你保存的东西可能会悄悄过期。这个问题有自己的修复办法,并不是真正的多智能体问题,所以我就不多说了。 ↩
-
还记得那次不稳定运行中的奇怪一行吗?它现在在磁盘上某个地方。但第三天的智能体不知道它存在,更不知道它重要,所以它不知道要去找它,也不知道该 grep 什么。又回到阅读了。 ↩
-
多智能体系统有很多种,我们找到了一些很好的抽象来表达它们。这篇博文有更多内容。 https://www.primeintellect.ai/blog/multi-agent-systems ↩
-
它仍然可能误读问题或带回错误的东西。但朝着一个已知目标压缩,比朝着一个未知目标压缩要容易得多。 ↩
-
当然,是在不违反阿姆达尔定律的前提下。 ↩
-
Noam Brown 在 Dwarkesh Podcast 上称其为“一种并行而非纯串行地扩展测试时计算的方式”。 ↩
-
只要任务能拆成若干部分,并且这些部分之间靠简短消息就能应付。如果每个部分都需要其他所有部分的完整上下文,那么再怎么拆分也没用,你又回到需要一个更大窗口的局面。 ↩
-
这假设模型完美地使用其上下文。在实践中,一个小而专注的上下文常常胜过一个巨大而混乱的上下文,但那就是我说过要忽略的上下文腐烂问题。 ↩
-
这有个花哨的名字叫通信复杂度:当每一方持有问题不同部分时,各方为了解决问题必须交换多少信息。 ↩
-
OpenAI 的说法,数学家们仍在核查。 ↩
-
罗纳德·科斯,《企业的性质》(1937)。 ↩
-
人类组织也弄明白了这一点:大公司里的数据库专家会收到每个团队的问题。如果他们只能为自己的经理工作,那你就得每个团队配一个。 ↩
-
F. A. 哈耶克,《知识在社会中的运用》(1945)。 ↩
-
出自 Fred Brooks 的《人月神话》:向一个已经延期的软件项目增加人手会让它更晚,部分原因是沟通路径的数量大约按团队规模的平方增长。 ↩
-
Rich Sutton,《苦涩的教训》(2019):随着算力扩展的通用方法最终会击败建立在人类知识之上的方法。 ↩